OpenAI ha risolto il problema di esistenza e regolarità di Navier–Stokes con uno sciame di agenti. Il modello che l’ha fatto è interno e non scaricabile; il certificato della dimostrazione sta su GitHub e si compila in locale.
L’8 settembre 2026 OpenAI ha annunciato una dimostrazione di blowup in tempo finito per Navier–Stokes: esiste un fluido inizialmente liscio, sottoposto a una forza esterna regolare, la cui velocità diverge prima di un istante finito. Sono le alternative (C) e (D) della formulazione ufficiale del Clay Institute (uno dei sette problemi del millennio, aperto dal 2000 e con un milione di dollari in premio), le due che prevedono una confutazione e le sole che ammettono un termine forzante non nullo: (A) e (B) lo pongono a zero, ed è la differenza su cui i matematici pesano il risultato. Il comunicato è pieno di numeri sugli agenti. Il repository che lo accompagna contiene 2.659 file Lean: il proof assistant in cui le dimostrazioni sono programmi che un compilatore verifica.
L’orchestrazione, in numeri
Il gruppo che ha chiuso il problema contava circa 10.000 agenti attivi in parallelo, divisi in sottogruppi che comunicano solo al proprio interno, con un armamentario minimo, che comprende una copia cache del web e l’esecuzione di codice.
Gruppi diversi hanno ricevuto varianti diverse del problema: (A) e (B), che porterebbero a una dimostrazione, e (C) e (D), a una confutazione. Nessuna scommessa a priori sul verso della risposta. Prima è stato risolto un problema che OpenAI classifica come «più facile», la regolarità di Euler non forzata: le stesse equazioni senza il termine di viscosità, quello che smorza il moto e ostacola la singolarità. Un centinaio di agenti, una cinquantina di ore. Quel risultato è diventato il prompt degli agenti richiamati dagli altri problemi del millennio e riversati su Navier–Stokes. E a run avviato Codex ha letto gli output intermedi dei gruppi, li ha consolidati e li ha rilanciati come follow-up. Il gruppo vincente è stato guidato così.
Il conto finale: 88 ore, 2,7 milioni di messaggi, circa 130 miliardi di token di output solo per Navier–Stokes; 300 miliardi su tutti i problemi tentati, che ai prezzi pubblici di GPT-6 Astra varrebbero una quindicina di milioni di dollari, ed è la tariffa di un modello meno capace di quello effettivamente usato, quindi una stima per difetto (il calcolo è di Simon Willison). Poi le altre 17 ore, quelle di formalizzazione e verifica in Lean, che nel comunicato occupano mezza riga.
La parte che si può eseguire
Il repository è pubblico, licenza Apache-2.0: openai/NavierStokesAndEuler, Lean 4.34.0-rc2 su mathlib, la libreria matematica della comunità. Servono elan e due comandi di lake, il build tool:
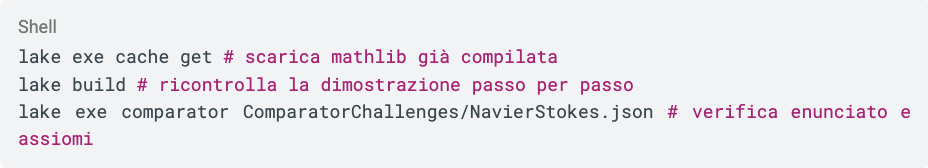
Ricompilare fa ricontrollare ogni passaggio dal kernel di Lean, il nucleo minimale che è l’unica parte su cui credere: la dimostrazione regge. Nessuna chiave API, nessun modello coinvolto: qui si paga in CPU, non in token. Ma su una prova generata da un’IA contano altre due domande. Dimostra l’enunciato giusto? Ci arriva senza scorciatoie?
L’enunciato da colpire non sta nel file della soluzione: vive in un file a parte, dove al posto della dimostrazione c’è un sorry, il segnaposto che in Lean chiude un obiettivo senza dimostrarlo. È la sfida, scritta prima e altrove, adattata dal progetto Formal Conjectures di DeepMind.
Il modulo con la soluzione chiude quell’enunciato e termina con una istruzione che elenca tutto ciò su cui la dimostrazione poggia.
Gli assiomi ammessi sono elencati in un JSON: propext, Quot.sound, Classical.choice, i tre su cui poggia l’intera logica di Lean. Comparator ricontrolla la soluzione con il kernel di Lean e, quando la sfida lo richiede, come qui, con un secondo kernel indipendente (nanoda_bin); la compilazione gira dentro una sandbox (landrun). Quello che certifica è che il teorema dimostrato sia lo stesso della sfida, che non sopravviva nessun sorry e che non compaia alcun assioma oltre ai tre ammessi. L’assunzione di fiducia si riduce a una sola: che almeno uno dei due kernel sia corretto. I prerequisiti sono tre binari da mettere nel PATH.
Due comandi, e la fiducia si sposta da chi ha prodotto la prova a chi la controlla.
Quello che la compilazione non certifica.
Il kernel garantisce che la prova sia valida e completa. Non garantisce che l’enunciato dimostrato sia il problema che ci interessava. Quella corrispondenza è un file scritto da esseri umani, e qui vale doppio perché l’enunciato viene da Formal Conjectures di DeepMind, indipendente da chi ha prodotto la prova: è il vero motivo per cui la verifica ha valore, molto più del fatto che il codice compili. Il forcing è la prova che la questione non è teorica: la stessa formalizzazione che il kernel accetta ammette un termine forzante, e su quel dettaglio si decide se il risultato vale (C) del Clay nel senso che importa ai matematici. La fiducia non scompare, si sposta: dal modello al kernel, e dal kernel a chi ha scritto l’enunciato.
L’asimmetria
Trovare la dimostrazione è costato 88 ore di agenti e 130 miliardi di token. Controllarla costa una compilazione, su hardware che non ha niente di speciale. È questa sproporzione a rendere il risultato un risultato, invece di un annuncio. Buttare calcolo sul problema, nel momento della risposta, funziona a una condizione: che esista un oracolo capace di dire sì o no senza passare da chi la risposta l’ha generata. Lean è quell’oracolo, ed è anche l’unica parte dell’esperimento che un terzo può riprodurre: del modello interno sappiamo quello che ci hanno raccontato.
Fuori dalla matematica formale, il pezzo che manca non è il motore della verifica: è l’enunciato. In un progetto software, prima dell’inizio dei lavori nessuno ha scritto il file che dice cosa sarebbe stato giusto fare, e quel file non lo può generare l’agente che poi va controllato. Si scrive a mano, e prende nomi meno solenni: test eseguibili, invarianti, contratti, whitelist di dipendenze. Sembra sempre tempo sottratto al lavoro vero, finché non si prova a far girare degli agenti senza. Senza, diecimila agenti producono 130 miliardi di token che nessuno può controllare.
In azienda l’oracolo va scritto
Costruire quel verificatore è la parte di lavoro che non finisce mai nel preventivo, ed è quella su cui abbiamo scelto di investire con AI WhiteBox.
Sembra sempre tempo sottratto al lavoro vero, finché non si prova a far girare degli agenti senza. Senza, diecimila agenti producono 130 miliardi di token che nessuno può controllare.
Riferimenti
Fonti primarie
- OpenAI, On the Navier–Stokes Millennium Prize Problem – 8 settembre 2026, aggiornato il 10 con l’esito dell’indagine sui dati di training. Da qui i numeri su agenti, messaggi, token e tempi.
- Finite time blowup for Navier–Stokes e Finite time blowup for the Euler equation – i due paper.
- Clay Mathematics Institute, Existence and smoothness of the Navier–Stokes equation – le alternative (A)-(D) sono a pagina 2.
Codice
- openai/NavierStokesAndEuler – Apache-2.0, Lean 4.34.0-rc2. Sfida, soluzione, assiomi ammessi, istruzioni di verifica.
- leanprover/comparator – il verificatore indipendente.
- Lean e mathlib — il linguaggio e la libreria matematica su cui poggia tutto.
- google-deepmind/formal-conjectures – la formalizzazione dell’enunciato Clay da cui derivano le sfide.
Sulla disputa
- Simon Willison, Some thoughts on the Navier–Stokes Millennium Prize Problem – 8 settembre 2026, precedente all’aggiornamento OpenAI del 10.
- Tristan Buckmaster, dichiarazione sui fatti (PDF, NYU).